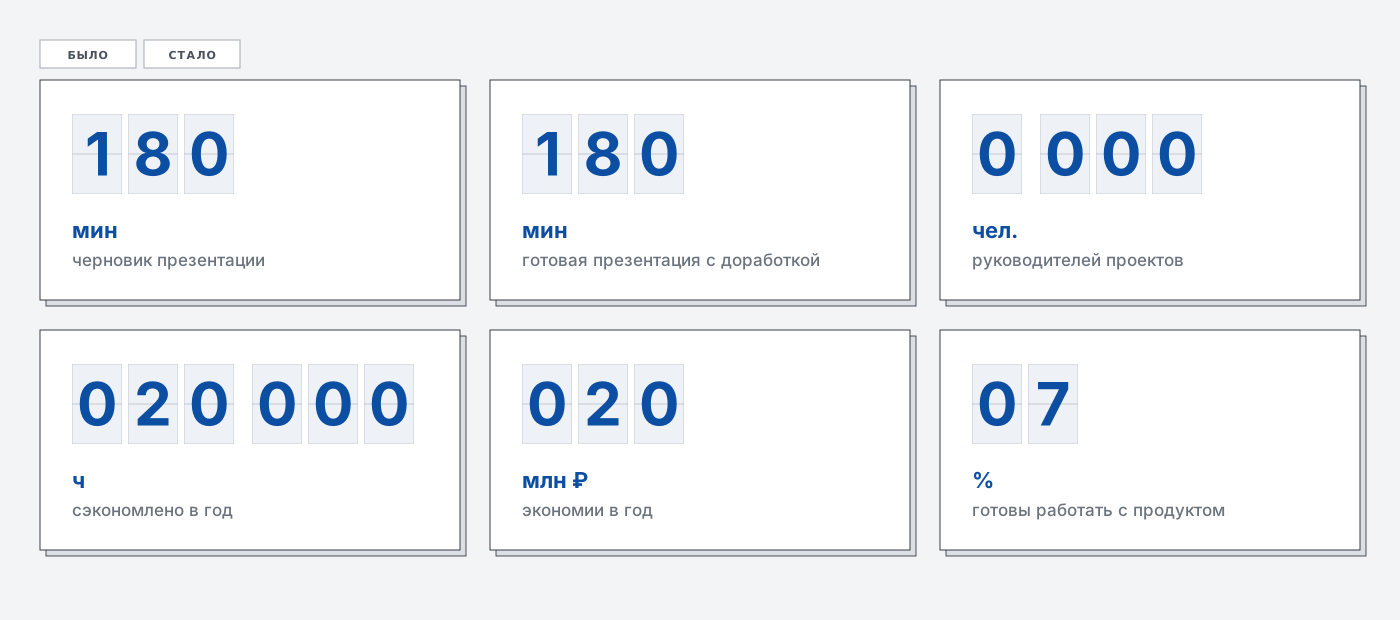
Презентации в крупной компании — это часы ручной работы, которые повторяются каждую неделю. В металлургической компании, где я работаю, эту работу теперь делает продукт, который я построил. Он получает текст, собирает из него презентацию в фирменном стиле и отдаёт редактируемый PowerPoint. Работает он внутри корпоративного контура на внутренней модели компании. Сейчас его раскатывают на всех сотрудников, около 50 000 человек, и он экономит компании десятки миллионов рублей.
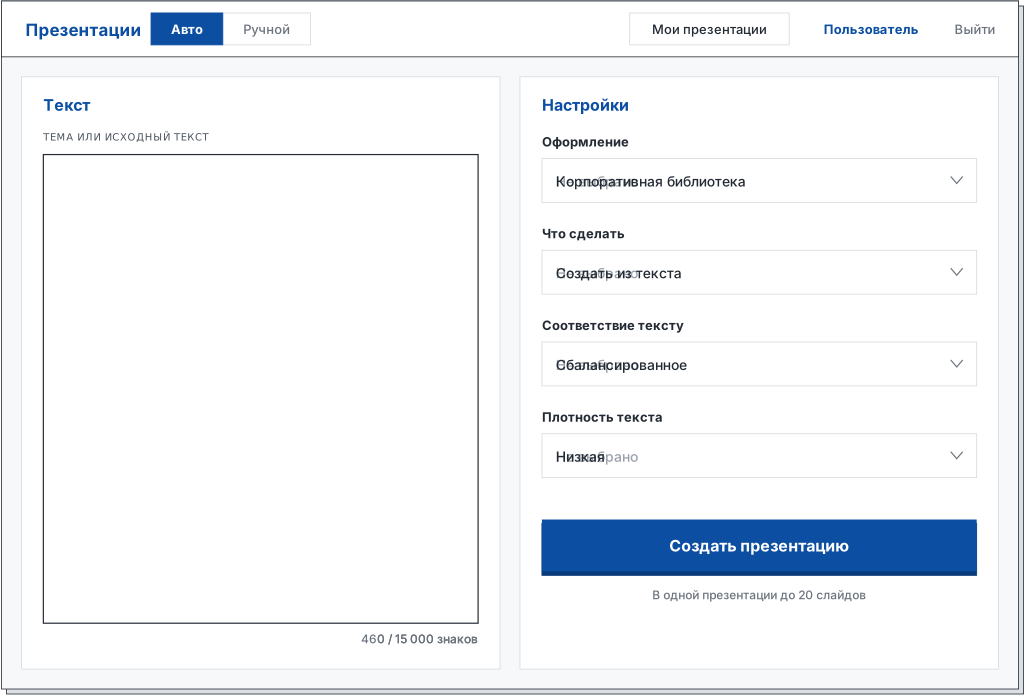
У продукта два экрана. На первом пользователь вставляет тему или исходный текст до 15 000 знаков и выбирает настройки: оформление, что сделать с текстом, насколько близко держаться к нему и плотность текста на слайдах. Режимов два: в автоматическом шаблоны подбирает система, в ручном человек сам задаёт шаблон для каждого слайда. После запуска генерации открывается экран просмотра: слева лента слайдов, в центре выбранный слайд, под ним оценка и теги проблем. Готовую презентацию до 20 слайдов можно скачать редактируемым PPTX.
Начиналось всё с выбора. Компания присматривалась к готовым российским решениям, но ни одно не подходило целиком: одни решали другую задачу, другие стоили слишком дорого. Мне предложили за две недели собрать свой вариант. Прототип я сделал в n8n, low-code-платформе, где процесс складывается из блоков и стрелок. Контекст лежал в Google Таблицах, шаблоны были подготовлены заранее. Через две недели результат можно было ставить рядом с решениями вендоров, и компания решила развивать продукт сама.
Дальше работа шла месячными спринтами. Каждый заканчивался одним из двух: переходом на новую архитектуру или пользовательским тестированием. Код в основном писали агенты, Claude Code и Codex CLI. Я проектировал систему, ставил задачи и принимал результат.
Сам продукт тоже агент: он делает работу дизайнера презентаций. Получалось, что одного агента я строил руками другого. Для такой работы есть термин Agentic Experience, по аналогии с User Experience. У него две стороны: как устроить среду, в которой агенту понятно работать, и как человеку работать с агентом в паре. Эта статья про обе.
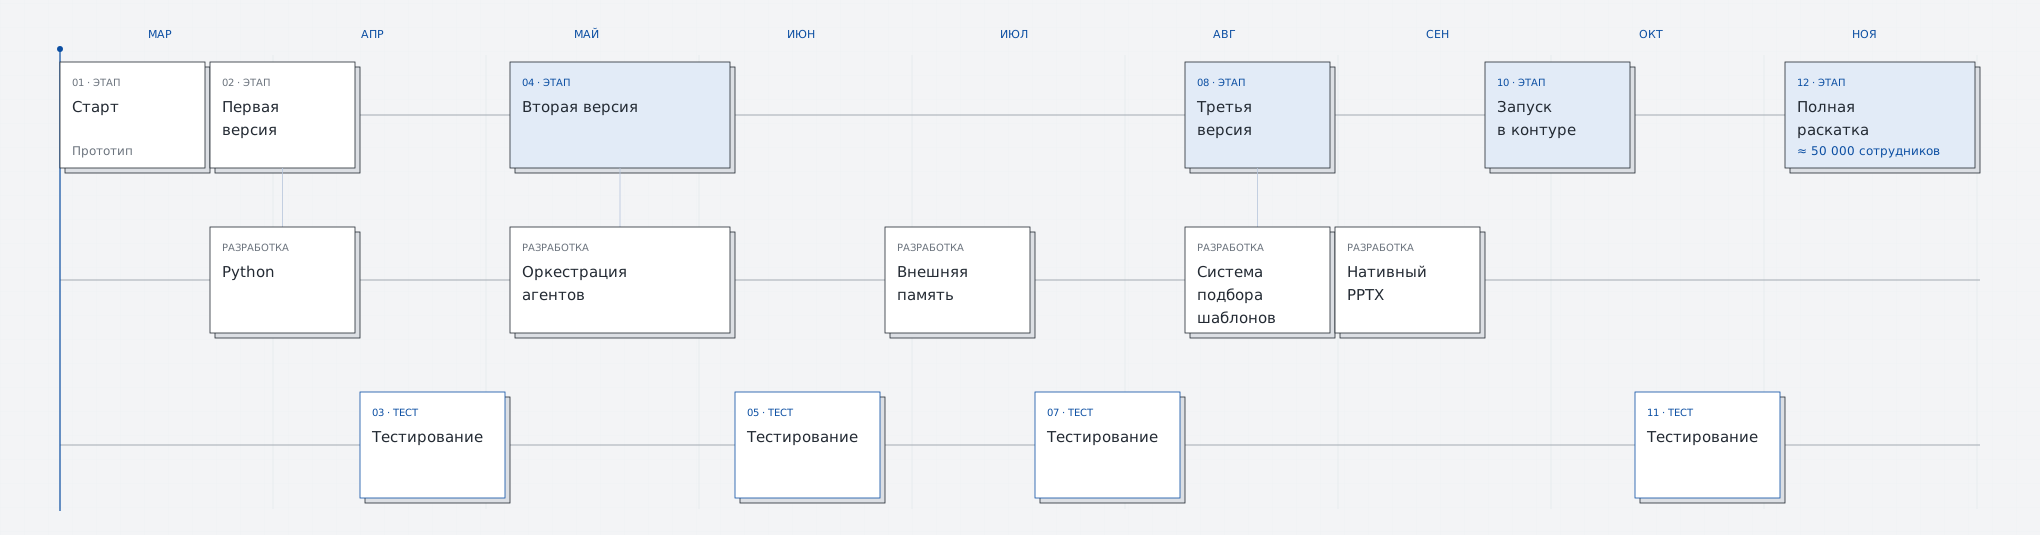
Первая версия: Python и один агент
Первая версия была написана на Python. Сервер на FastAPI, интерфейс на обычном JavaScript, часть процесса в n8n. Генерацию выполнял воркер на Python и Bash, который запускал Claude CLI.
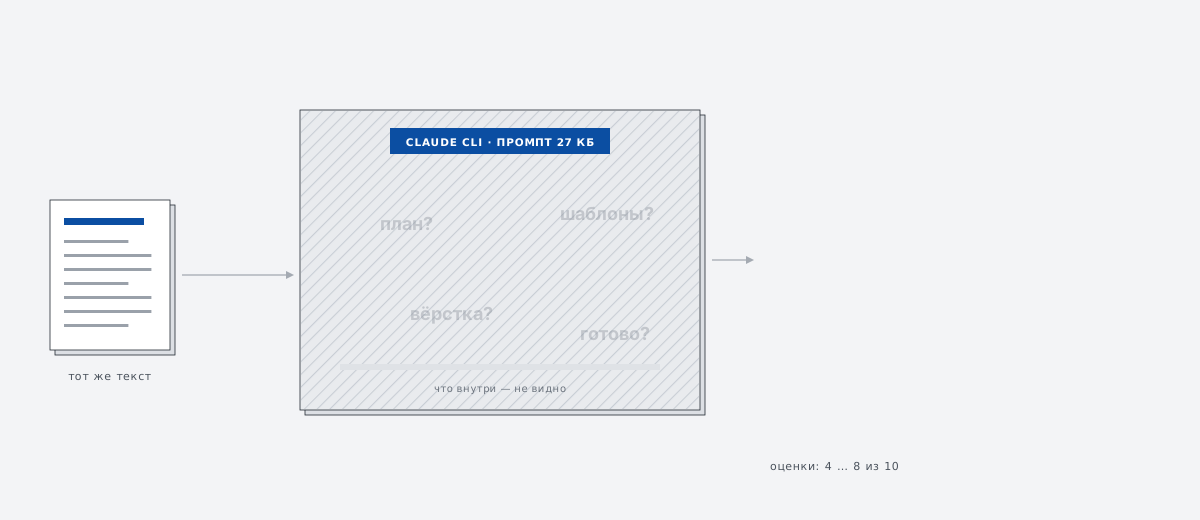
Claude в этой версии одновременно делал работу и управлял процессом: читал текст, планировал слайды, выбирал шаблоны, верстал и сам решал, когда закончить. Всё, что ему нужно было знать, лежало в одном промпте. С каждой ошибкой промпт рос.
Иногда получалась хорошая презентация. Иногда после получаса работы выходила слабая, и я не мог понять, на каком этапе возникла проблема: в плане, в выборе шаблона или в вёрстке. Новое правило в промпте могло исправить одно и сломать другое. Однажды выяснилось, что агент какое-то время работал с отключённым файлом инструкций и выключенным подбором шаблонов, а по результату этого было не видно.
Вторая версия: шесть шагов
Я разложил работу агента так, как работает дизайнер: план, подбор шаблона, заполнение слайда, скриншот и проверка, сборка, сохранение. У каждого шага свой небольшой промпт, свой вход и выход, свои таймауты и повторы при ошибке.
Вторую версию я сделал на TypeScript. Next.js стал основой интерфейса и серверной части, а Payload CMS добавил административную панель, авторизацию и работу с PostgreSQL. Puppeteer снимал скриншоты слайдов для проверки. Причин перейти с Python было две. Впереди был онлайн-редактор слайдов, тяжёлое фронтовое приложение, и удобнее иметь один язык для интерфейса и сервера. Вторая причина касалась агента-разработчика. В Python данные между частями системы передавались словарями, и агент легко называл поле в одном месте slide_id, а в другом slideId. Ошибка всплывала пустым слайдом у пользователя. В TypeScript структура описана один раз, и при расхождении проект не собирается.
Шагами управляет Temporal, движок оркестрации процессов. Он запускает шаги, повторяет упавшие, ограничивает их по времени и хранит историю каждого запуска. Логика процесса в нём описывается кодом, а код агент пишет и читает хорошо. Схему из визуальных блоков пришлось бы собирать вручную.
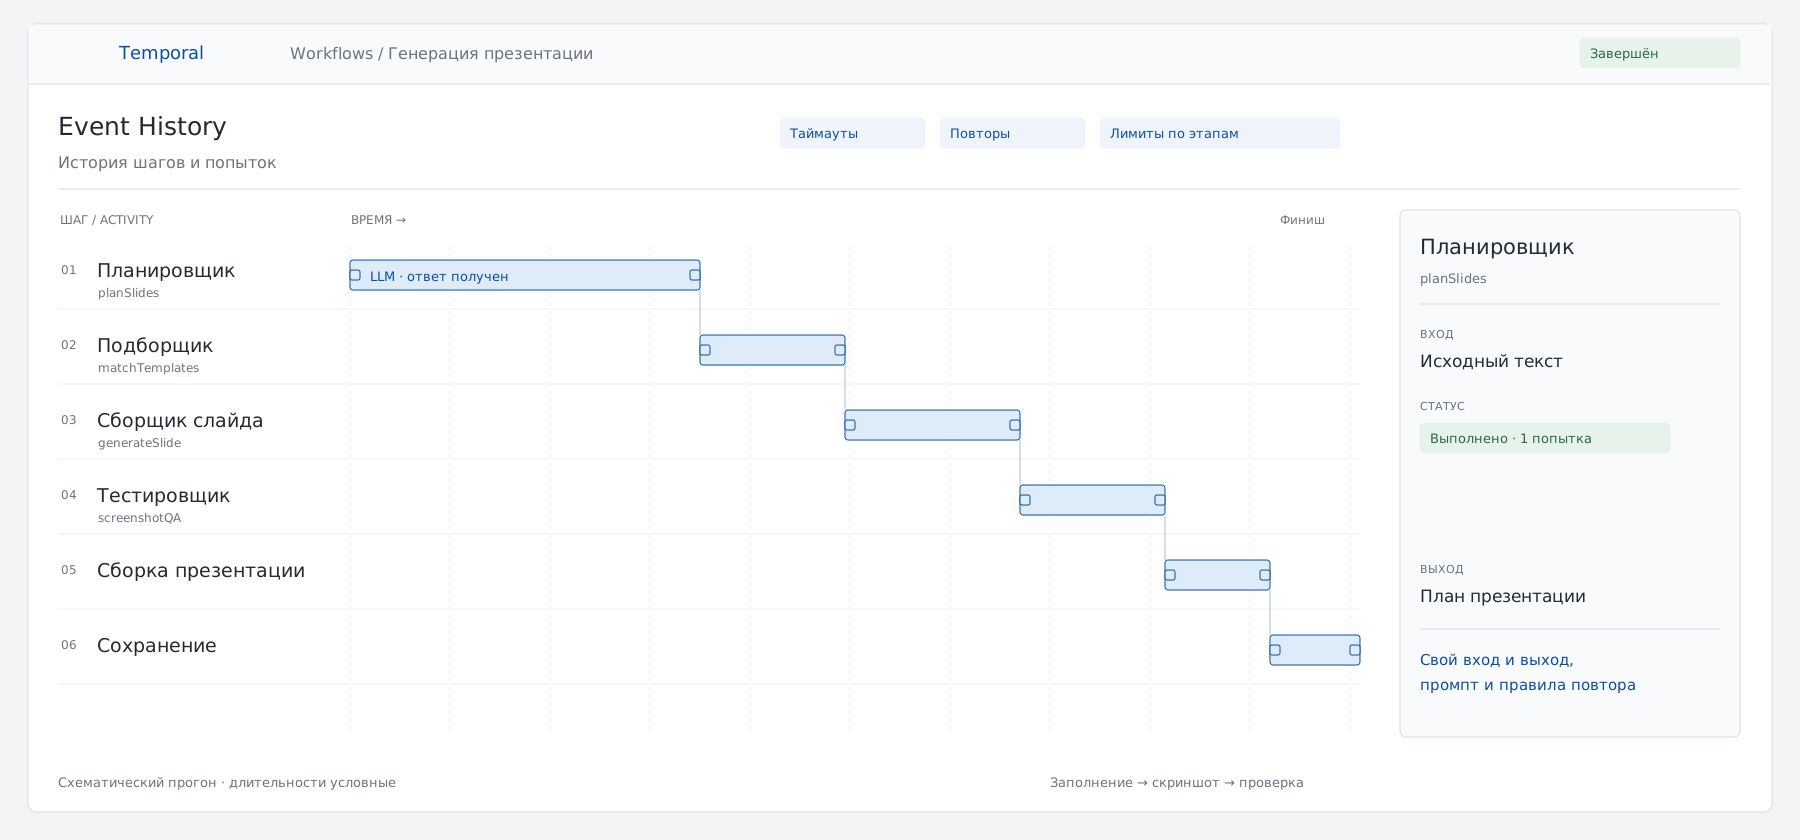
Первый прогон дал шесть слайдов за 36 минут с оценками от 4 до 8 из 10. На временной шкале Temporal было видно, на что уходит время. Слайды не зависят друг от друга, поэтому заполнение я развёл на параллельные задачи с лимитами по этапам, до двенадцати одновременно на воркер.
Генерацию я запускал через Claude и Codex CLI. Отдельно проверял, потянет ли задачу небольшая локальная модель: Gemma 4 26B через Ollama справилась, но восемь слайдов делала около 45 минут. Позже модели подключались через OpenRouter.
Теперь ошибки модели были привязаны к шагу. На шаге генерации она писала «традиционный подход 35% против нового 92%», хотя таких цифр в тексте не было. Правило «числа брать только из текста» я добавил в промпт именно этого шага, остальные шаги не менялись.
Внешний контекст для агента-разработчика
Агент-разработчик каждую сессию начинает с нуля. Сначала я пересказывал ему решения, что-то забывал, и он возвращал в код подход, от которого мы отказались неделю назад.
Контекст я вынес из репозитория в трекер задач на отдельном сервере. Там хранятся задачи, решения, архитектура, правила проекта и история сессий. Агент читает это через API в виде структурированного текста, я вижу те же данные на доске и на графе архитектуры. В начале сессии агент берёт правила, карточку задачи, соседние задачи, нужный срез архитектуры и записи прошлых сессий. В конце записывает результат и коммит.
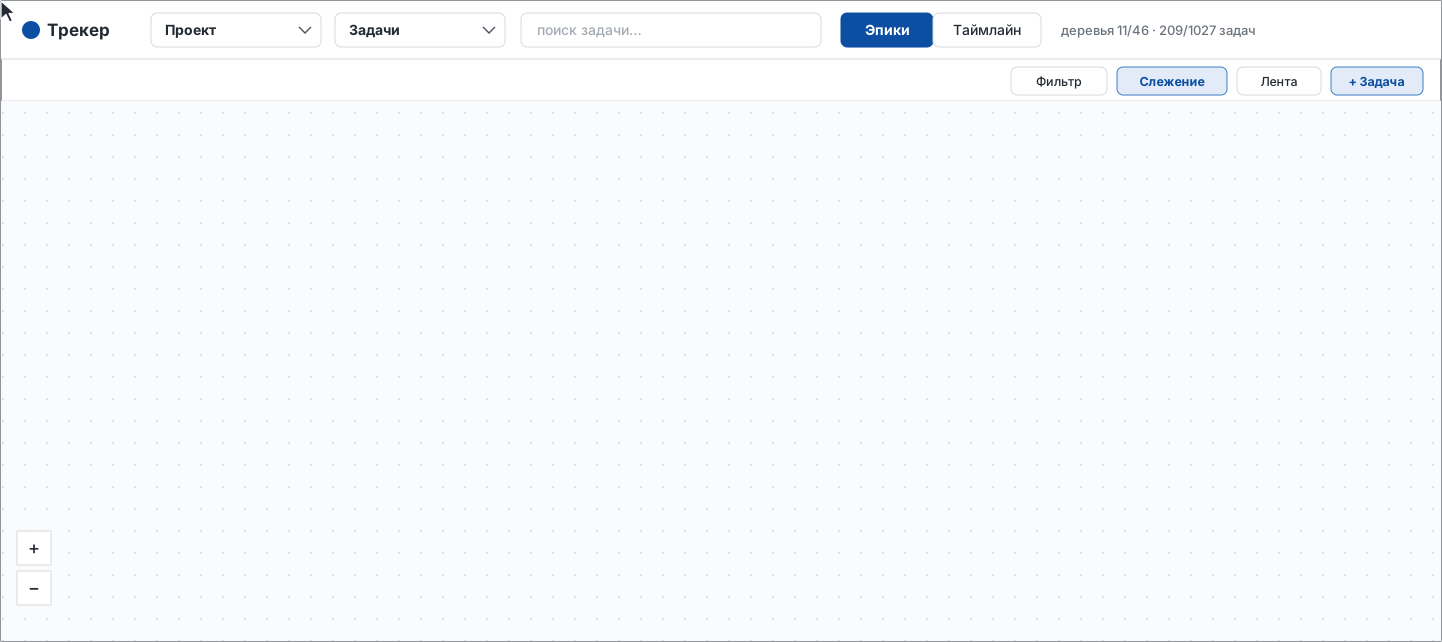
Старые решения не стираются. Они получают пометку «заменено» и ссылку на новое. Неудачные подходы остаются с отдельным статусом тупика и причиной. Когда агентов стало несколько, каждая задача пошла в отдельный git worktree. Один агент выполняет задачу, другой проверяет, решение принимаю я.
Подбор шаблона
Выбор шаблона под слайд оказался самой трудной частью.
Сначала я навёл порядок в библиотеке: 282 разрозненных шаблона заменил на 132 канонических HTML-шаблона. Для каждого описал назначение, сценарии применения и синонимы. Эти описания превращались в эмбеддинги и складывались в векторную базу Qdrant. Запрос строился из плана слайда.
Поиск по смыслу находил шаблон по теме, но ничего не знал о вместимости. Пять пунктов попадали в шаблон на три карточки. Тогда модель составила для каждого шаблона структурное описание в JSON по HTML и PNG-превью: сетка, слоты и их вложенность, повторяющиеся группы, минимальное, максимальное и типичное число элементов, фиксированные элементы, поведение при переполнении.
Как соединить смысл и структуру, было неясно, и я сделал шесть вариантов процесса, каждый отдельным workflow в Temporal. Основным режимом стал вариант с повторным подбором: подобрать шаблон, переписать текст под него и подобрать ещё раз. Остальные ушли в трекер как тупики с причинами.
Нативный PowerPoint: что решает модель, а что код
Пользователям нужен был редактируемый PowerPoint. Конвертация из HTML теряла детали. Я рассмотрел около десяти подходов и перешёл на прямую сборку PPTX через библиотеку. Получение PPTX стало отдельным workflow.
Ответственность разделилась жёстче. Модель возвращает спецификацию содержания в JSON. Код выводит из неё признаки, отсеивает неподходящие формы из реестра и оценивает оставшиеся по числу записей, набору полей, вместимости и возможности реально собрать слайд. Координаты считает код по токенам фирменного стиля, модель их не задаёт.
Под содержание, для которого в реестре нет формы, композер собирает её из примитивов. Зоны он рассчитывает через Yoga, движок flexbox-раскладки. Основным путём стал композер. Новые формы композера не допускаются к пользователям до моего ручного подтверждения.
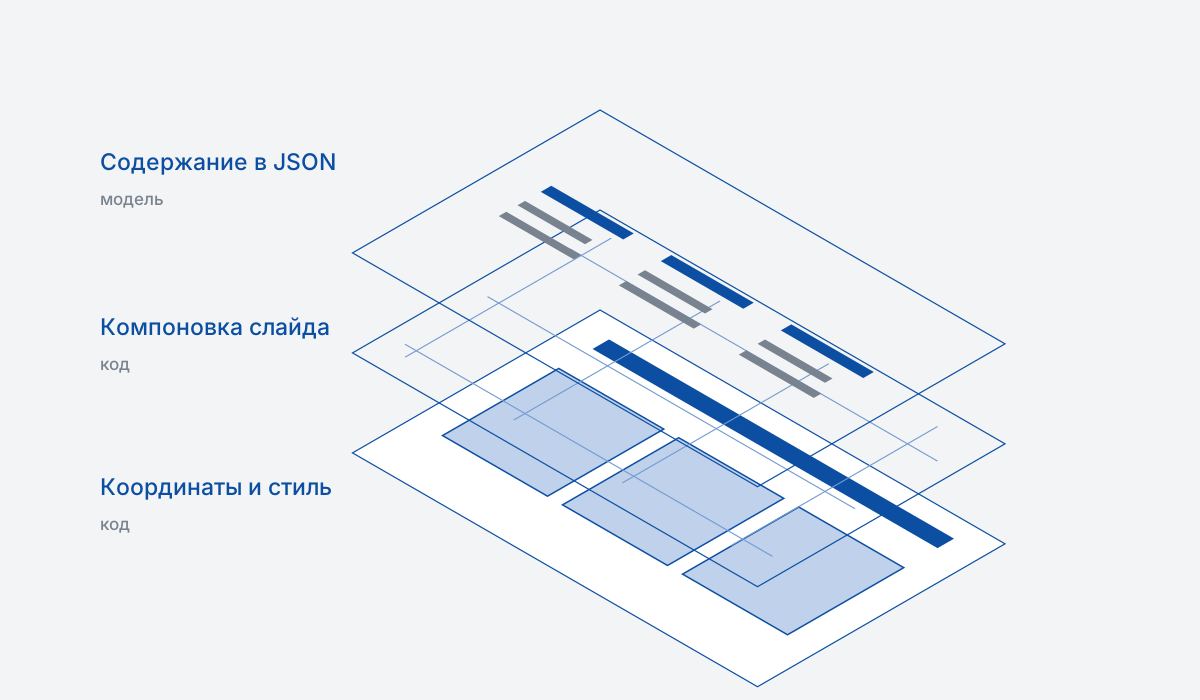
Однажды на слайде с командой весь текст был на месте, но роли стояли под чужими фамилиями: при разбивке на страницы поля перепутались между записями. У каждой записи появились стабильные идентификаторы и проверка, что поля остались у своей записи. Числа код сверяет с исходным текстом. Регрессии вёрстки ловят семь эталонных кейсов, которые рендерятся через LibreOffice и сравниваются с порогом 1,5%.
Пользовательское тестирование
До переноса в корпоративный контур прошли две волны пользовательского тестирования. Под каждым слайдом можно было поставить оценку и отметить проблему: неверный формат, сломанная вёрстка, выдуманные числа, потерянный текст. Оценки и теги попадали в аналитический дашборд с разрезами по генерациям, слайдам, пользователям и шаблонам. По этим данным я сравнивал варианты конвейера и находил дефекты, а исправления вносились в промпты и код. Модель от оценок не меняется.
Один тестировщик написал, что сервис ему не подходит. В разговоре выяснилось, что ему нужен один сложный слайд с диаграммой Ганта. За день я добавил ручной режим: пользователь сам задаёт шаблон и текст для каждого слайда, автоматический подбор пропускается, система только заполняет и собирает. На следующий день пользователь подтвердил, что задача решена.
Эксплуатация и закрытый контур
Однажды генерация встала примерно на два часа: сервер подвисал из-за нехватки памяти. После этого появились скрипты развёртывания и отката, проверка работоспособности, резервные копии и раздельные стенды для разработки и рабочей версии.
Адрес модели и её выбор я вынес в переменные окружения. Продукт обращается к OpenAI-совместимому API и не зависит от провайдера. Внутри контура внешних моделей нет, и при переезде поменялись только настройки.
Сначала нужно было довести качество и экспорт в PowerPoint и дать заказчикам попробовать продукт. Когда очередь дошла, я подготовил комплект для офлайн-развёртывания: Docker-образы, скрипты, начальные данные. Пилот подняли на Astra Linux: приложение, воркер, PostgreSQL, Qdrant, Temporal и сервис эмбеддингов. Для согласования с информационной безопасностью я подготовил C4-диаграммы и описание потоков данных и разобрал результаты SAST и SCA.
Промышленная платформа
Для работы на всех сотрудников продукт нужно было развернуть на корпоративном Kubernetes. Опыта с ним у меня не хватало, и проверить конфигурацию, написанную агентом, я бы не смог. Подключилась команда разработчиков. Она переписала кодовую базу на принятом в компании стеке: Java и Spring Boot на сервере, React в интерфейсе. Появились корпоративный вход через Keycloak, шлюз к внутренним моделям, очередь шагов в PostgreSQL вместо Temporal и S3-совместимое хранилище. Генерация осталась разбитой на те же шаги.
За мной остались продуктовая логика, сценарии, требования, качество, приоритеты и приёмка. Задачи команде я ставил так же, как агентам: цель, контекст, критерии приёмки, проверка результата.
В октябре продукт приняли. В одном из промежуточных опросов 97% участников сказали, что готовы с ним работать. Теперь доступ постепенно получают все сотрудники компании.
Что я понял
Большую задачу агенту нужно отдавать частями, у каждой свой вход, выход и промпт. Работу агента нужно сделать видимой, иначе ошибки исправляются наугад. Контекст для агента-разработчика должен жить вне сессии и вне головы человека, вместе с решениями и тупиками. Модели можно доверить работу с содержанием, геометрию и сверку фактов надёжнее делать кодом. Обратную связь пользователей нужно собирать в виде данных и проверять гипотезы из неё быстро.
Через весь проект прошла одна мысль: работу агентов нужно видеть. Подсветка блоков в n8n, дорожки Temporal, доска и граф архитектуры в трекере. Агентов будет больше, и они будут работать друг с другом. Людям понадобится способ видеть эту работу, и этим я собираюсь заниматься дальше.